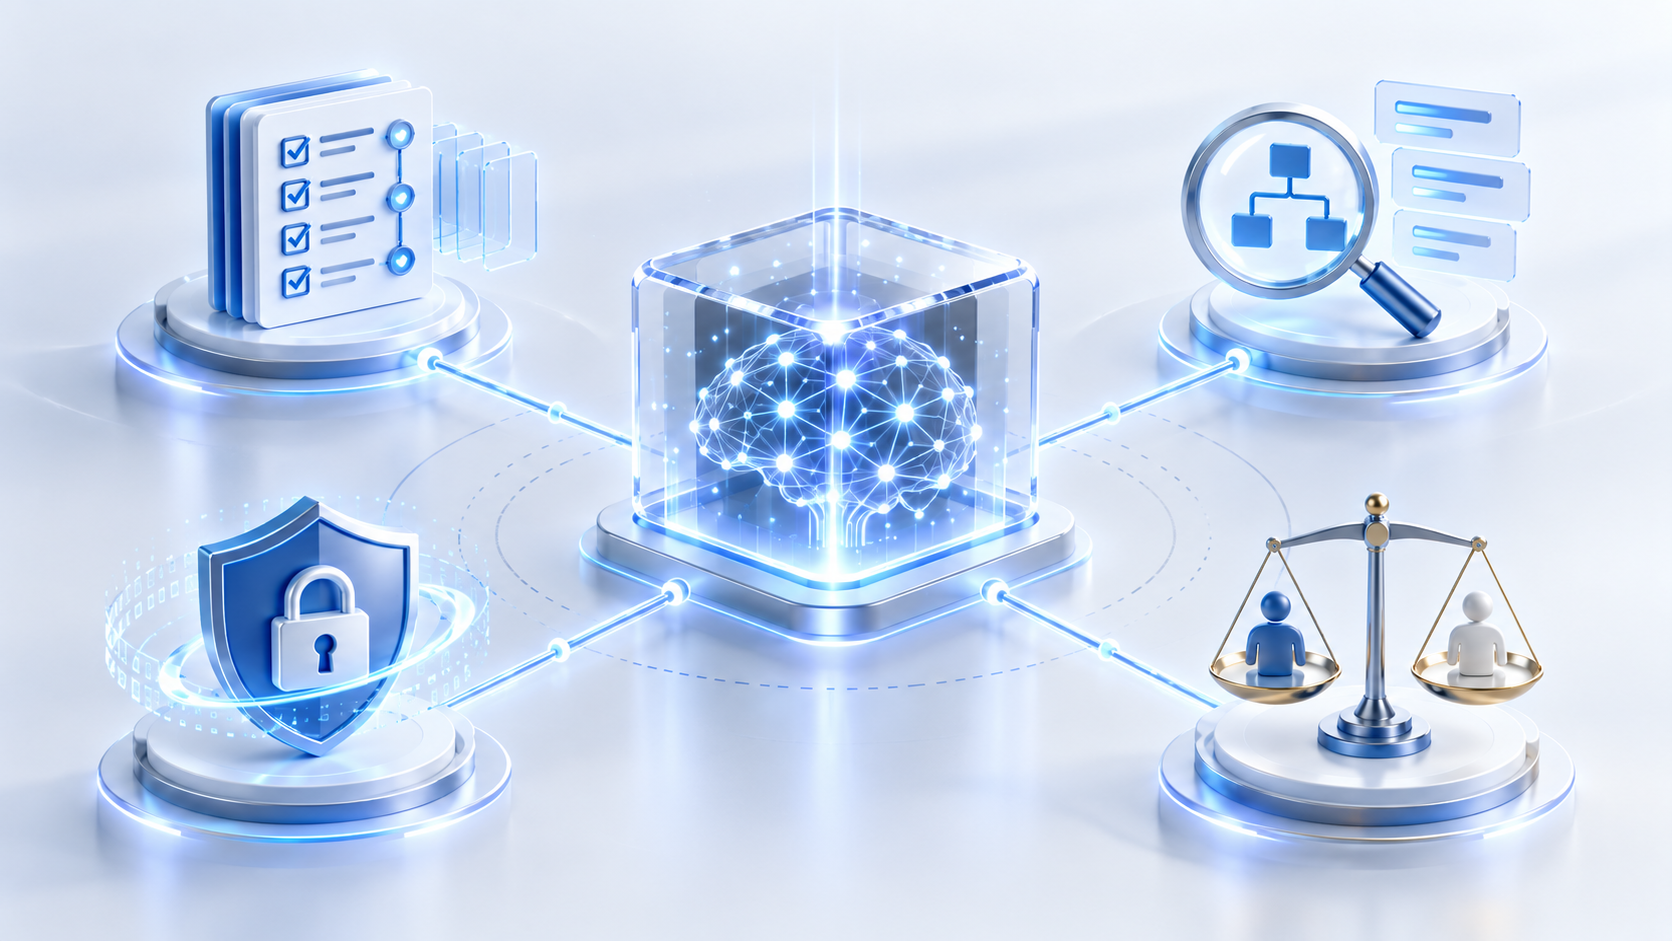
這篇文章是介紹 NIST AI RMF 第三章系列文章的最後一篇。當 AI 系統真正進入組織與使用者的決策情境後,除了前一篇文章1中提到的三面向外,尚有另外四個面向,分別是可追溯與透明(Accountable & Transparent)、可解釋與可理解(Explainable & Interpretable)、隱私強化(Privacy-Enhanced),以及公平與有害偏見受到管理(Fair – With Harmful Bias Managed)。相較於前一篇較偏向系統本身的有效性、安全性與韌性,這四個面向更直接牽涉到 AI 與人、組織及社會之間的互動。換言之,AI 不只要「做得對」,還需要讓人知道它為什麼這樣做、誰該為結果負責、使用者的資料是否受到妥善保護,以及不同群體是否受到合理且公平的對待。接下來本文將分別介紹這四個面向:
Accountable & Transparent
可信賴的 AI 必須具備問責(Accountable)性,而問責又建立在透明(Transparent)的基礎上。這裡的透明不是單純把所有資訊公開,而是依照 AI 系統所處的生命週期階段,以及不同角色的知識與需求,提供適當程度的資訊。這些資訊可能涵蓋系統設計決策、訓練資料、模型訓練方式、預期用途,以及部署與實際使用過程中的重要決策。
透明的目的之一,是讓人能夠理解 AI 系統發生了什麼事情,並在錯誤或負面影響發生時,具有追查與補救的可能性。因此,資料來源、決策紀錄以及相關文件都可能成為支援透明與問責的重要機制。當然提升透明與問責本身需要投入資源,也因此在思考此面向的實現時,還必須考量商業機密、專有資訊以及智慧財產權等限制。換言之,透明並不是資訊揭露越多越好,而是要在風險、使用需求與實施成本之間取得適當平衡。
此外,AI 的透明工具與相關文件都仍在持續發展,因此 AI 系統的開發者應與部署者充分合作,實際測試不同形式的透明工具,並確認這些工具是否真的有助於系統被正確理解與使用,而不是只滿足於「總之有使用工具」這件事本身,或乾脆把所有能用的工具全部堆上去,彷彿工具越多就代表透明度越高。真正重要的不是有沒有工具、用了多少工具,而是這些工具是否真的產生預期效果,也才能讓資源投入更有效。
Explainable & Interpretable
當 AI 系統開始參與判斷與決策時,只知道系統「給了什麼答案」往往還不夠。如果使用者、操作人員或監督者無法理解系統如何形成結果,或者不知道這個結果在實際情境下代表什麼,就可能錯誤使用、過度信任,甚至無法在系統出現問題時察覺與處置。可解釋(Explainable)與可理解(Interpretable)便是此七面向中用於處理上述問題的關鍵面向。所謂的可解釋指的是對 AI 系統運作機制的描述與說明,也就是幫助人理解系統如何產生某個結果,而可理解則著重於 AI 系統的輸出在其原本功能與使用情境下代表什麼意義。兩者共同幫助系統操作人員、監督者與使用者,可以更進一步理解系統功能、輸出與可信程度。
缺乏可解釋性所帶來的風險,可以透過適合不同角色、知識與技能程度的方式說明系統如何運作來降低。NIST AI RMF 也指出較具可解釋性的系統通常更容易進行除錯與監控,也更有利於文件化、稽核與治理。至於缺乏可理解性所帶來的風險,則可以透過說明 AI 為什麼做出某項預測或建議,以及這個結果對使用者而言代表什麼,來降低錯誤解讀的可能性。
說到這,我們應該再把前一面向中談到的透明與此面向中的兩種特性放在一起看,以便對可信賴的 AI 有更深的了解,也更能掌握三者分別所對應到不同問題:
- 透明:系統裡「發生了什麼」?
- 可解釋:這個決定「是怎麼形成的」?
- 可理解:這個結果「為什麼會出現,以及對使用者代表什麼」?
Privacy-Enhanced
NIST 對隱私的理解,不只是避免資料外洩,而是更廣泛地保障人的自主性、身分與尊嚴,包括免於私人生活或私人領域受到侵擾(freedom from intrusion)、限制對個人的觀察與監控(limiting observation),以及讓個人對自身資訊的揭露與身分相關面向保有一定程度的決定與控制能力。因此,AI 系統在設計、開發與部署時,應考量匿名性、機密性與控制權等隱私價值。此外,AI 也可能帶來新的隱私風險,例如從原本看似無法直接識別的資料中,推論出個人身分或原本屬於私人範圍的資訊。
組織可以透過隱私強化技術(Privacy-Enhancing Technologies, PETs)、資料最小化、去識別化(De-identification)與資料彙總(Aggregation)等方法降低隱私風險。不過隱私強化也可能和其他可信賴特性產生權衡,例如在資料稀疏時,隱私保護措施可能降低準確度,進一步影響公平性等其他判斷。
Fair - With Harmful Bias Managed
當討論到 AI 的公平時,那代表同時需要考慮平等與公平性,且需要處理有害偏見與歧視等問題。不過,需要理解的是即使有害偏見已經被降低,那也不代表系統就一定公平。這是因為公平本身會受到文化、使用情境與社會條件影響,而且不同群體對公平的理解也可能不同。
此外,AI 系統所涉及的偏見問題也不見得只來自於資料本身。關於 AI 系統的偏見問題,NIST AI RMF 提出了三大類:
- 系統性偏見(Systemic Bias):存在於資料、組織規範、流程或更大的社會結構中。
- 計算與統計偏見(Computational and Statistical Bias):來自資料樣本、演算法與統計處理中的系統性偏差。
- 人類認知偏見(Human-Cognitive Bias):來自人如何理解資訊、做決策,或如何看待 AI 系統的目的與功能。
理解這些偏見並不代表重點就是「把偏見消除」,而是辨識並管理可能造成傷害的偏見。因為偏見不一定都帶有惡意,也不一定完全能被消除,但 AI 系統可能讓既有偏見以更快、更大規模的方式被延續或放大,而這也正是 NIST AI RMF 在公平面向中特別強調的重點。
從這四個面向可以看出,AI 的可信賴性並不是只靠模型表現或系統功能就能建立。當 AI 真正進入組織與人的決策環境後,還需要能夠被追溯與問責、讓使用者理解其運作與結果、保護個人的隱私,並且持續管理可能造成傷害的偏見。更重要的是,這些面向並不是彼此獨立的。提高透明度可能影響隱私,強化隱私又可能影響準確度與公平,而追求可解釋性也可能帶來新的資訊揭露與治理成本。因此,NIST AI RMF 第三章真正想提醒我們的,並不是把七個面向逐一「做到最好」,而是根據實際情境、風險與利害關係人的需求,在不同可信賴特性之間做出合理的權衡。換言之,可信賴 AI 並不存在一個放諸四海皆準的標準答案,而是一個需要在系統整個生命週期中持續判斷、調整與治理的過程。
1. NIST AI Risk Management Framework(RMF) 系列文章 - Valid & Reliable、Safe、Secure & Resilient, https://www.cpht.pro/blog/blog-post-62/
如果你也正在思考如何在組織內的資訊系統與流程內追尋持續改善,那麼 CPHT 的豐富經驗和能力將會是你最好的選擇! 👉 了解更多: https://www.cpht.pro